Política de uso de dados
Ao navegar por este site, você concorda com a política de uso de dados.Política de uso de dados
Ao navegar por este site, você concorda com a política de uso de dados.Introdução a PINNs
Ajude a manter o site livre, gratuito e sem propagandas. Colabore!
2.3 Rede perceptron multicamadas
Uma rede perceptron multicamadas (MLP, do inglês, multilayer perceptron) é um modelo de rede neural feedforward formada por composições de camadas de perceptrons. A Figura 2.6 contém um esquema de uma MLP. Observemos que a rede é formada por uma camada de entrada, camadas escondidas e uma camada de saída. Cada camada é formada por um conjunto de neurônios, cada um com sua própria função de ativação. A saída da rede é calculada por composições das camadas, i.e. a saída da primeira camada é a entrada da segunda camada, e assim sucessivamente.
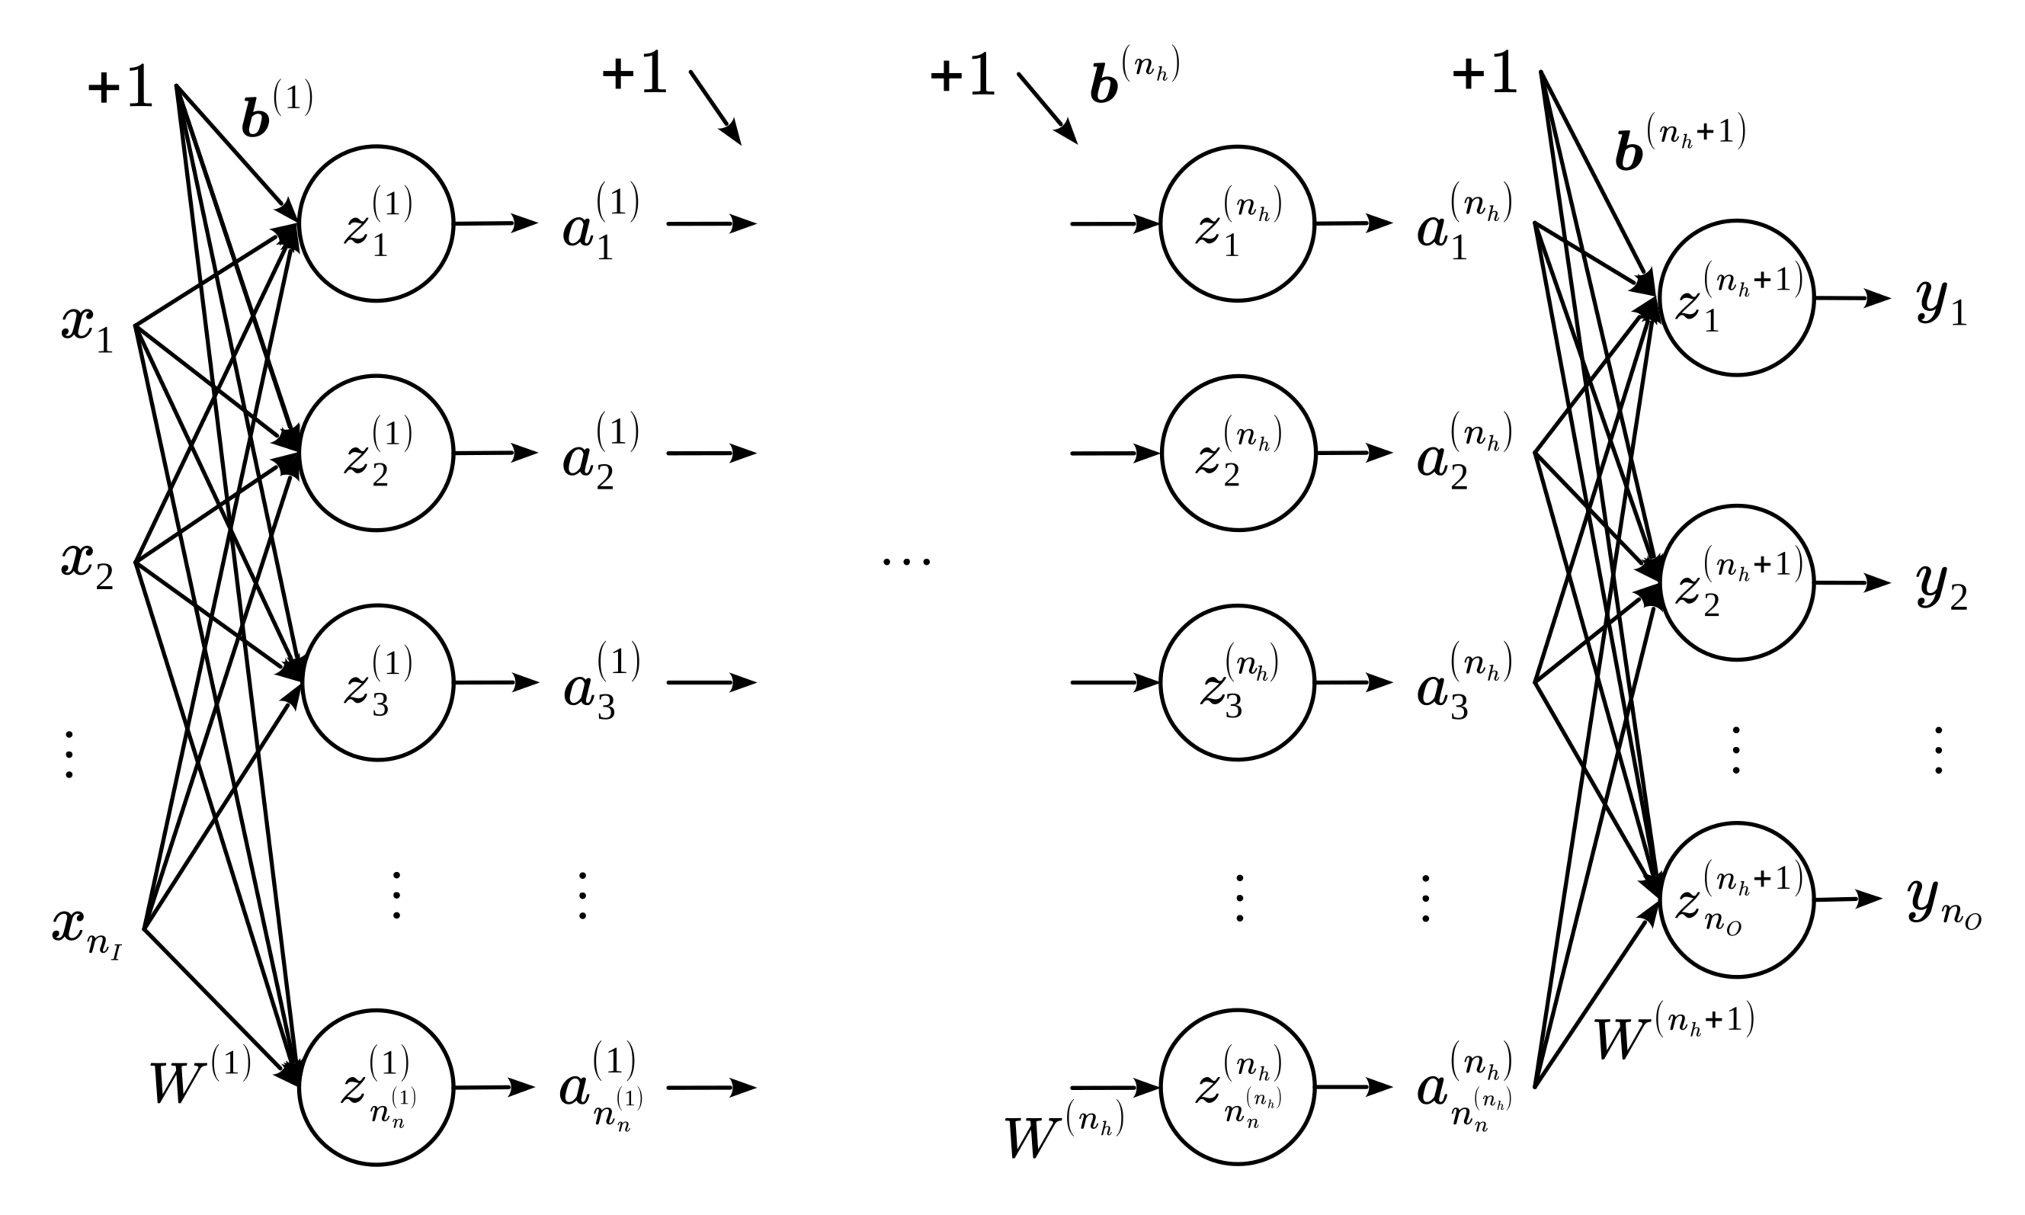
Denotamos uma MLP de camadas por
| (2.47) |
onde são os parâmetros do modelo, sendo os parâmetros (pesos matriz de números reais e biases vetor de números reais) da camada , onde denota o número de camadas escondidas. É assumido conhecidos a priori o número de entradas , o número de neurônios de cada camada escondida , o número de camadas escondidas e o número de saídas . Também, são conhecidos a priori as funções de ativação de cada camada , onde é a pré-ativação da camada , i.e.,
| (2.48) |
para , denotando a entrada por e a saída por .
De forma mais precisa, o cálculo da inferência de uma entrada na rede é feito por iteradas composições das camadas, i.e., a saída da rede é calculada pela iteração
| (2.49) |
para , lembrando que a entrada é vetor de números reais e é vetor de números reais.
Exemplo 2.3.1.(Modelo xor)
No E.2.1.5, vimos que não é possível criar um perceptron para emular a operação lógica xor. Por outro lado, esta operação é equivalente a seguinte combinação de operações lógicas
| (2.50) |
Com isso, podemos criar uma MLP com duas entradas, uma camada escondida com dois neurônios e uma camada de saída com um neurônio, como ilustrado na Figura 2.7.
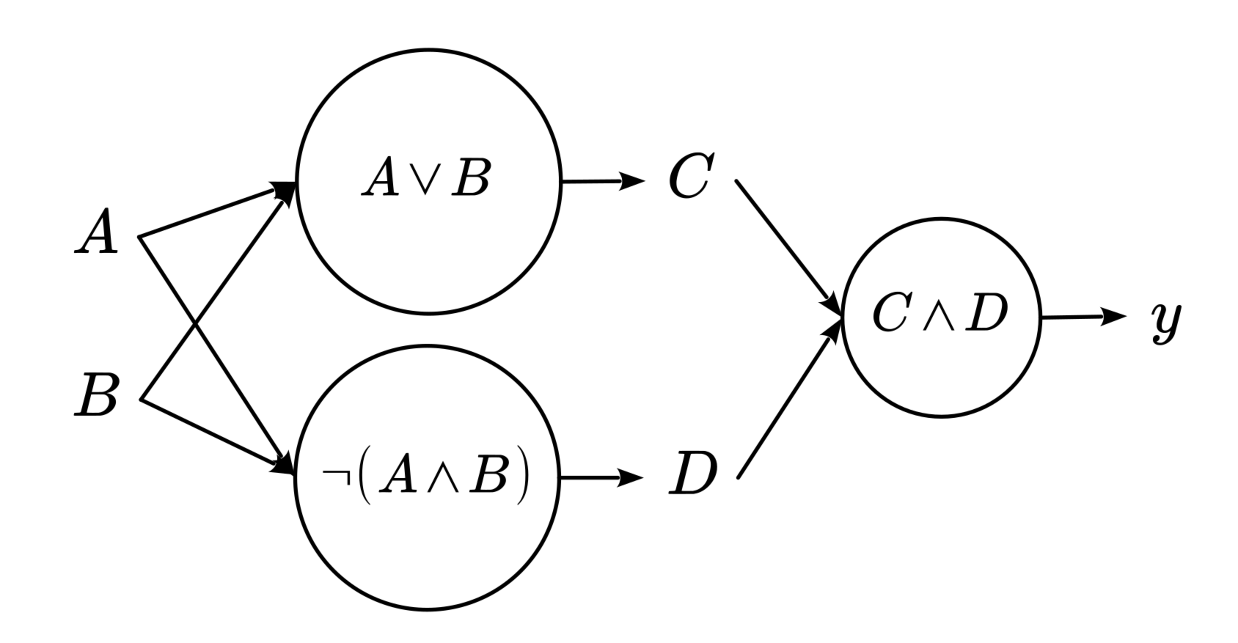
Seguindo esta arquitetura de rede, o Código 5 contém a implementação de uma MLP para emular a operação lógica xor. Verifique! No código, as entradas são representadas por (verdadeiro) e (falso), e a saída da rede é interpretada como verdadeiro se for maior que zero e falso caso contrário. As funções de ativação são funções sinal, i.e. . Na primeira camada escondia, o primeiro neurônio emula a operação lógica or e o segundo neurônio emula a operação lógica not and. A saída da rede é a operação lógica and entre as saídas dos dois neurônios da camada escondida.
2.3.1 Treinamento por retropropagação
A ideia do treinamento por retropropagação que estudamos na Seção 2.3.1 para o perceptron, pode ser diretamente estendida para o treinamento de uma MLP. A diferença é que, agora, temos mais parâmetros a serem ajustados e, portanto, mais gradientes a serem calculados.
Vamos assumir uma MLP
| (2.51) |
Para o treinamento da rede, assumimos uma função de perda da forma
| (2.52) |
onde , é a função de perda da -ésima amostra, i.e. uma função dos parâmetros do modelo , onde é o número de parâmetros da rede.
O treinamento da rede consiste em resolver o problema de minimização
| (2.53) |
Aplicando um método baseado em gradiente, temos o seguinte algoritmo:
-
1.
aproximações iniciais.
-
2.
Para :
-
(a)
-
(a)
onde, é o número de épocas, é a taxa de aprendizagem e é o vetor direção da atualização dos parâmetros, com
| (2.54) | |||
| (2.55) |
Observação 2.3.1.(Otimizadores)
O método de atualização dos parâmetros da rede pode ser feito por diferentes otimizadores baseados em gradiente. Em acada método há uma forma diferente de calcular o vetor direção , que pode depender do gradiente atual e de gradientes anteriores. Na Seção 2.3.1, estudamos o método do gradiente descendente (GD) e o método do gradiente descendente estocástico (GDE), que são métodos de atualização dos parâmetros da rede com base no gradiente atual. Ambos os métodos podem ser aplicados para o treinamento de uma MLP e mais adiante, vamos estudar outras variantes de otimizadores baseados em gradiente.
O cálculo dos gradientes pode ser feito por retropropagação como uma aplicação da regra da cadeia. Para os pesos da última camada, temos888Com um certo abuso de linguagem devido à álgebra matricial envolvida.
| (2.56) | |||
| (2.57) |
Para os pesos da penúltima camada, temos
| (2.58) | |||
| (2.59) | |||
| (2.60) |
e assim, sucessivamente para as demais camadas da rede. Os gradientes em relação aos biases podem ser calculados de forma análoga (consulte o E.2.3.1).
Em todos os casos, notemos que o cálculo do gradiente da função de perda em relação aos parâmetros da rede é feito de forma retroativa, ou seja, a partir da saída da rede e voltando-se para os parâmetros da rede. Ainda, as derivadas envolvidas, usualmente, podem ser calculadas de forma analítica e armazenadas durante a etapa de propagação, evitando-se a repetição de cálculos. Por fim, o cálculo do gradiente da função de perda pode ser feito por um processo de acumulação, tendo em vista que a função de perda é uma soma de funções de perda das amostras.
Exemplo 2.3.2.(Modelo xor com treinamento)
No E.2.3.1, estudamos que é possível criar uma MLP para emular a operação lógica xor. No entanto, os parâmetros da rede foram escolhidos de forma manual. Aqui, vamos criar uma MLP para este mesmo problema, mas agora vamos treinar a rede para ajustar os parâmetros de forma automática.
Vamos assumir uma rede com duas entradas, uma camada escondida com dois neurônios e uma camada de saída com um neurônio. Para garantir a diferenciabilidade, vamos assumir que todas as funções de ativação são funções tangente hiperbólica, i.e. . A função de perda é a função erro quadrático médio
| (2.61) |
onde são os valores estimados e , , o conjunto de treinamento conforme na Tabela 2.4.
O Código 6 contém a implementação do treinamento da MLP com otimizador GD. Verifique!
2.3.2 Exercícios
E. 2.3.1.
Para uma MLP com camadas com função de perda da forma (2.52), calcule os gradientes:
-
a)
.
-
b)
.
-
c)
.
-
d)
.
E. 2.3.2.
E. 2.3.3.
Faça uma nova versão do Código 6, substituindo o otimizador GD pelo otimizador GDE. Faça uma análise comparativa entre os dois métodos de treinamento, considerando o número de épocas e a taxa de aprendizagem.
E. 2.3.4.
No exercício anterior (E.2.3.3), você deve ter observado que ambos os otimizadores GD e GDE podem cair em mínimos locais, dependendo da inicialização dos parâmetros da rede. Modifique seus códigos de forma que eles busquem identificar quando estão presos em mínimos locais e, nesse caso, parem o treinamento.
E. 2.3.5.
No Exemplo 2.3.1, criamos uma MLP para emular a operação lógica xor com base na combinação de operações
| (2.62) |
Esta não é a única forma de combinar as operações lógicas or, and e not para calcular a xor. De fato, observe que o Código 6 treina uma nova MLP a cada execução do código, com diferentes parâmetros iniciais e acaba convergindo para diferentes soluções. Faça a análise das redes treinadas e, através da análise dos parâmetros treinados, descubra que outras combinações de operações lógicas podem ser utilizadas para emular a operação lógica xor.
Envie seu comentário
Aproveito para agradecer a todas/os que de forma assídua ou esporádica contribuem enviando correções, sugestões e críticas!

Este texto é disponibilizado nos termos da Licença Creative Commons Atribuição-CompartilhaIgual 4.0 Internacional. Ícones e elementos gráficos podem estar sujeitos a condições adicionais.