Política de uso de dados
Ao navegar por este site, você concorda com a política de uso de dados.Política de uso de dados
Ao navegar por este site, você concorda com a política de uso de dados.Introdução a PINNs
Ajude a manter o site livre, gratuito e sem propagandas. Colabore!
2.1 Unidade de processamento
A unidade básica de processamento111A unidade básica de processamento de uma RNA também é chamada de neurônio artificial ou nodo da rede. do tipo perceptron segue o esquema apresentado na Figura 2.1.
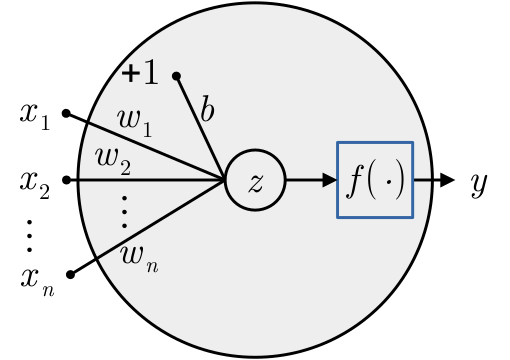
Consiste na composição de uma função de ativação222Originalmente, o perceptron tem a função sinal como função de ativação. Por referência histórica, vamos adotar este nome mesmo para unidades de processamento com outras funções de ativação com a pré-ativação
| (2.1) | |||
| (2.2) |
onde é o vetor de entrada, são os parâmetros da unidade, formados pelos pesos e pelo bias . Escolhida uma função de ativação, a saída do neurônio é computada por
| (2.3) | |||
| (2.4) |
O treinamento (calibração) consiste em determinar os parâmetros de forma que o neurônio forneça as saídas esperadas com base em um critério predeterminado.
2.1.1 Um problema de classificação
O perceptron é um classificador linear, i.e., é capaz de classificar dados que sejam linearmente separáveis. Como aplicação deste fato que demonstraremos mais adiante, vamos criar um perceptron que emule a operação booleana333George Boole, 1815 - 1864, matemático britânico. Fonte: Wikipédia: George Boole. (e-lógico). Para tanto, precisamos definir o problema, os dados originais de treinamento, o modelo do perceptron, o pré-processamento dos dados, o método de treinamento e, por fim, realizar a implementação do modelo.
Problema e dados de treinamento
Dados dois valores booleanos e (, verdadeiro ou , falso), esperamos que nossa unidade de processamento forneça como saída o valor booleano . Para isso, precisamos de um conjunto de dados de treinamento e de um critério de treinamento. Como dados, podemos usar a tabela verdade do e-lógico (consultemos aTabela 2.1). Esta tabela nos fornece um conjunto de dados de entrada e de saídas esperadas. O critério de treinamento será definido mais adiante.
Modelo
Nosso modelo será um perceptron
| (2.5) | |||
| (2.6) |
com entradas , , função sinal
| (2.7) |
como função de ativação, saída e parâmetros a determinar .
Pré-processamento
O pré-processamento dos dados de treinamento consiste em compatibilizá-los com o modelo. No caso em estudo, podemos assumir que o valor booleano (falso) seja associado a e que valor booleano (verdadeiro) a . Com isso, os dados de treinamento originais podem ser reescritos como na Tabela 2.2. Denotaremos o conjunto de treinamento pré-processado por , onde é o número de amostras, é o vetor de entrada da -ésima amostra e é a saída esperada para a -ésima amostra.
Treinamento
Agora, nos falta treinar nosso neurônio para fornecer o valor esperado de para cada entrada dada . Isso consiste em determinar o método (de treinamento) para escolher os parâmetros adequados para esta tarefa. Vamos explorar mais sobre isso na sequência do texto; aqui, vamos empregar uma análise geométrica para escolher os parâmetros.
Lembrando que nosso modelo é
| (2.8) |
observamos que
| (2.9) |
corresponde à equação geral de uma reta no plano . Esta reta divide o plano em dois semiplanos
| (2.10) | |||
| (2.11) |
O primeiro está no sentido do vetor normal à reta e o segundo no sentido oposto. Com isso, o problema de treinamento se reduz a encontrar os coeficientes da reta
| (2.12) |
de forma a separar o ponto no semiplano positivo e os demais pontos no semiplano negativo . Consultemos a Figura 2.2.
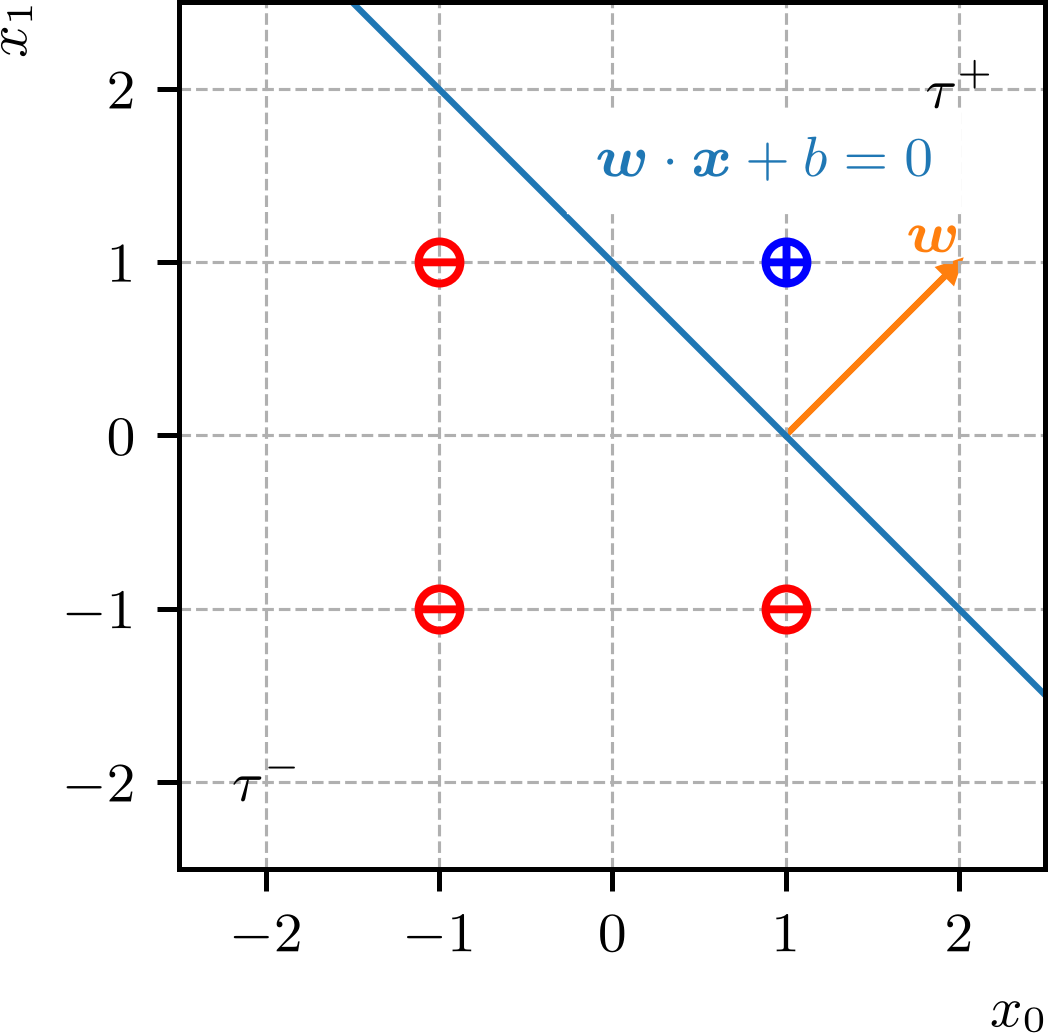
Com base nessa interpretação geométrica, podemos escolher os parâmetros do nosso modelo. Por exemplo, escolhendo e , temos o modelo
| (2.13) |
Verifique que o modelo fornece a saída esperada para cada entrada da Tabela 2.2!
Implementação
O Código 1 é uma implementação do modelo que criamos. Verifique!
2.1.2 Algoritmo de treinamento: perceptron
O algoritmo de treinamento perceptron permite computar os parâmetros do modelo para fazer a classificação de dados linearmente separáveis. Trata-se de um método para o treinamento supervisionado de um modelo, i.e., a calibração dos pesos é feita com base em um conjunto de amostras de treinamento que contém pares de entradas e saídas esperadas.
Seja dado um conjunto de treinamento , onde é o número de amostras, e , . O algoritmo consiste no seguinte:
-
1.
, .
-
2.
Para :
-
(a)
Para :
-
i.
Se :
-
A.
-
B.
-
A.
-
i.
-
(a)
onde, é um dado número de épocas. Usualmente, uma época é definida como o número de vezes que todas as amostras serão utilizadas para realizar a correção dos pesos.
Para mostrarmos a convergência do algoritmo de treinamento perceptron, vamos simplificar a notação, assumindo . Com isso, um conjunto é linearmente separável, se existe tal que
| (2.14) |
para todas as amostras . Com isso, temos o seguinte resultado.
Teorema 2.1.1.(Perceptron)
Seja dado um conjunto de treinamento , onde é o número de amostras. Se existe tal que
| (2.15) |
e , para todo , então o algoritmo de treinamento perceptron converge em no máximo correções.
Demonstração.
Assuma que iniciamos com e que na -ésima iteração de correção vamos computar os parâmetros . Seja o ângulo entre os vetores e , então
| (2.16) | |||
| (2.17) |
Sem perda de generalidade, suponhamos que a amostra seja a amostra que gera a correção na -ésima iteração, ou seja, . Com isso, temos
| (2.18) | |||
| (2.19) | |||
| (2.20) | |||
| (2.21) |
por indução matemática. Por outro lado, temos
| (2.22) | |||
| (2.23) | |||
| (2.24) | |||
| (2.25) |
novamente por indução matemática. Com isso, temos
| (2.26) |
e, portanto, . ∎
Aplicação
O Código 2 contém uma implementação do algoritmo de treinamento perceptron para o problema de classificação associado à operação lógica (e-lógico). Verifique!
2.1.3 Exercícios
E. 2.1.1.
Seja um perceptron com função sinal como função de ativação e parâmetros e . Esboce a reta de separação associada a este modelo e indique os semiplanos e . Então, classifique os seguintes pontos utilizando este modelo: , , e .
E. 2.1.2.
Crie um perceptron que emule a operação booleana do (ou-lógico). Treine o modelo utilizando:
-
a)
uma análise geométrica;
-
b)
o algoritmo de treinamento perceptron.
E. 2.1.3.
Crie um perceptron que emule a operação booleana do (negação-lógico). Treine o modelo utilizando:
-
a)
uma análise geométrica;
-
b)
o algoritmo de treinamento perceptron.
E. 2.1.4.
Crie um perceptron que emule a operação booleana (negação do e-lógico). Treine o modelo utilizando:
-
a)
uma análise geométrica;
-
b)
o algoritmo de treinamento perceptron.
E. 2.1.5.
Busque criar um perceptron que emule a operação lógica do xor (ou-exclusivo-lógico). É possível? Justifique sua resposta.
Envie seu comentário
Aproveito para agradecer a todas/os que de forma assídua ou esporádica contribuem enviando correções, sugestões e críticas!

Este texto é disponibilizado nos termos da Licença Creative Commons Atribuição-CompartilhaIgual 4.0 Internacional. Ícones e elementos gráficos podem estar sujeitos a condições adicionais.