Política de uso de dados
Ao navegar por este site, você concorda com a política de uso de dados.Política de uso de dados
Ao navegar por este site, você concorda com a política de uso de dados.Introdução a PINNs
Ajude a manter o site livre, gratuito e sem propagandas. Colabore!
2.4 Funções de ativação
Usualmente, a escolha das funções de ativação de uma rede é feita a priori em uma tomada de decisão que envolve suas características e o problema a ser resolvido. A escolha da função de ativação é importante, pois ela influencia diretamente na capacidade de aproximação da rede, na velocidade de convergência do treinamento e na estabilidade numérica do processo de retropropagação. Nesta seção, vamos estudar algumas das funções de ativação mais utilizadas em redes MLP para problemas de aproximação de funções, tema que iremos abordar com mais detalhes na próxima seção (Seção 2.5).
2.4.1 Função tangente hiperbólica
Nas aplicações anteriores usamos a função tangente hiperbólica como função de ativação em alguns modelos. A função tangente hiperbólica é uma função não linear, diferenciável e limitada, com valores de saída no intervalo . A Figura 2.8 contém o gráfico da função tangente hiperbólica e de sua derivada. Sua expressão analítica é dada por
| (2.63) |
e sua derivada é
| (2.64) |
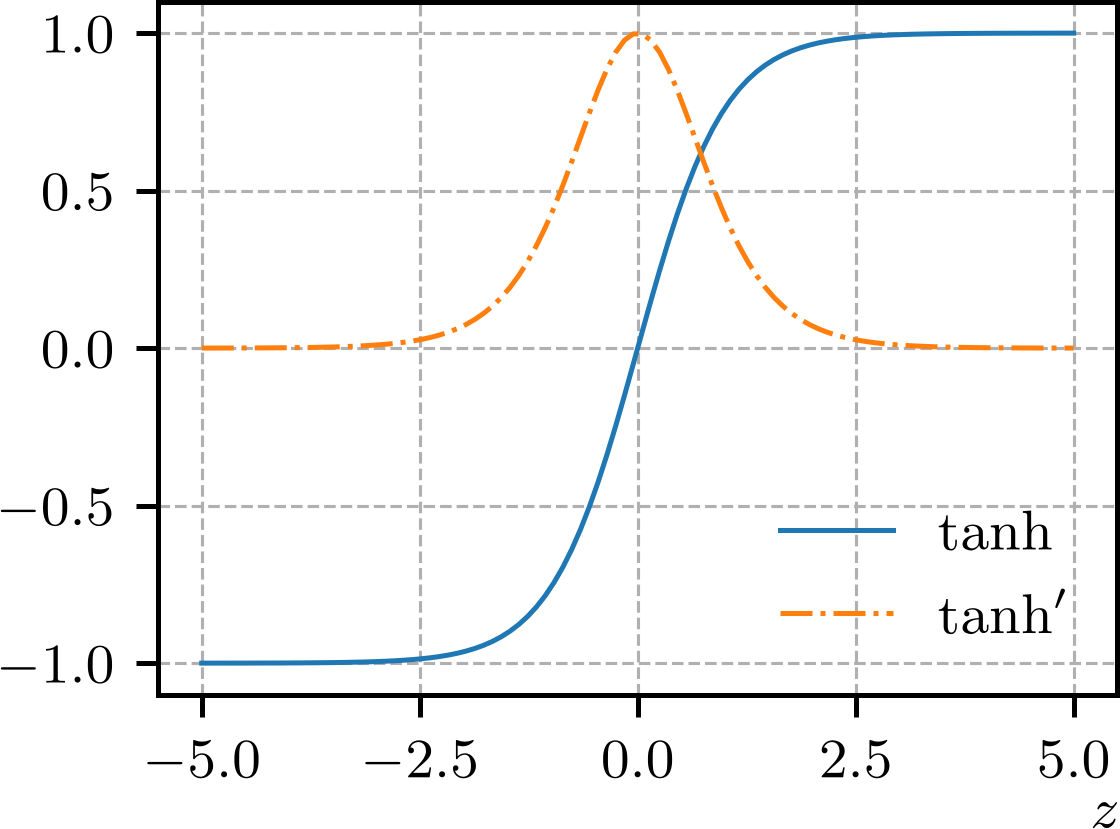
No Código 7 temos uma implementação da função tangente hiperbólica utilizando a biblioteca PyTorch. Verifique!
Algumas características da função tangente hiperbólica são:
-
•
Função suave.
É uma função suave com derivadas não nulas de todas as ordens. Esta é uma boa propriedade para o treinamento de redes neurais, pois garante que o gradiente da função de perda em relação aos parâmetros da rede seja bem definido e não nulo, mesmo quando envolve derivadas de ordens superiores, caso usual em aplicações envolvendo equações diferenciais.
-
•
Função monotonicamente crescente.
É uma função monótona crescente, i.e. se . Esta propriedade é importante para o treinamento de redes neurais, pois garante que a função de ativação preserve a monotonicidade dos valores de entrada, o que pode ser útil em problemas de classificação e regressão.
-
•
Ponto de inflexão.
Tem um ponto de inflexão em , i.e. e . Esta propriedade é importante para o treinamento de redes neurais, pois garante que a função de ativação tenha uma região de maior sensibilidade em torno do ponto de inflexão, o que pode ser útil para capturar variações sutis nos dados de entrada.
-
•
Função saturada.
É uma função saturada, i.e. contém assíntotas horizontais se e se . Esta propriedade pode ser um problema para o treinamento de redes neurais, pois pode levar ao problema do vanishing gradient, onde os gradientes da função de perda em relação aos parâmetros da rede se tornam muito pequenos, facilitando a estagnação do treinamento em mínimos locais.
-
•
Função limitada com derivada limitada.
É uma função limitada com derivada limitada: , . Esta é uma boa propriedade para o treinamento de redes neurais, pois ajuda na estabilidade numérica do processo de treinamento, evitando que os valores de saída da função de ativação se tornem muito grandes ou muito pequenos, o que poderia levar a problemas de overflow ou underflow numérico.
-
•
Custo computacional alto.
Em comparação com funções de ativação mais simples, a função tangente hiperbólica tem um custo computacional alto, o que é uma desvantagem em aplicações que exigem grandes redes neurais.
2.4.2 Função sigmoide
A função sigmoide999A função sigmoide na biblioteca PyTorch é a comumente chamada de função logística padrão na matemática. é uma função não linear, diferenciável e limitada, com valores de saída no intervalo . A Figura 2.9 contém o gráfico da função sigmoide e de sua derivada. Sua expressão analítica é dada por
| (2.65) |
e sua derivada é
| (2.66) |
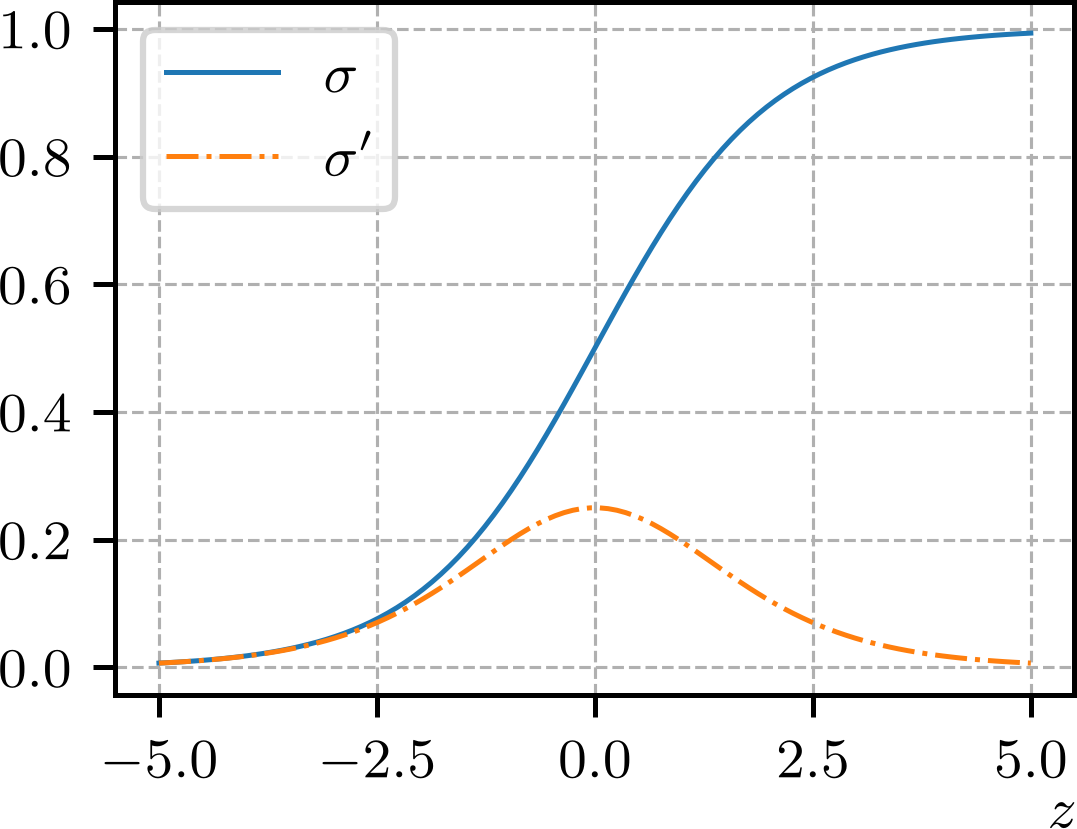
Algumas características da função sigmoide são:
-
•
Função suave.
-
•
Função monotonicamente crescente.
-
•
Ponto de inflexão.
-
•
Função saturada.
-
•
Função limitada com derivada limitada.
-
•
Custo computacional alto.
-
•
Função positiva.
Esta é uma das características que mais diferencia a aplicação da função sigmoide da função tangente hiperbólica no contexto de redes neurais. A função sigmoide é uma função positiva, i.e. para todo . Esta propriedade pode ser uma vantagem em problema em que a positividade seja uma propriedade a ser preservada.
2.4.3 Função ReLU
A função ReLU (do inglês, Rectified Linear Unit) é uma função não linear, diferenciável quase em todo o seu domínio e não limitada, com valores de saída no intervalo . A Figura 2.10 contém o gráfico da função ReLU e de sua derivada. Sua expressão analítica é dada por
| (2.67) |
Note que a função ReLU não é diferenciável em , mas é diferenciável em todo o restante do seu domínio. Para fins de aplicação no treinamento de redes neurais por retropropagação, a derivada da função ReLU é definida como101010A escolha aqui de tomar a derivada pela esquerda é arbitrária, mas é a utilizada na biblioteca PyTorch.
| (2.68) |
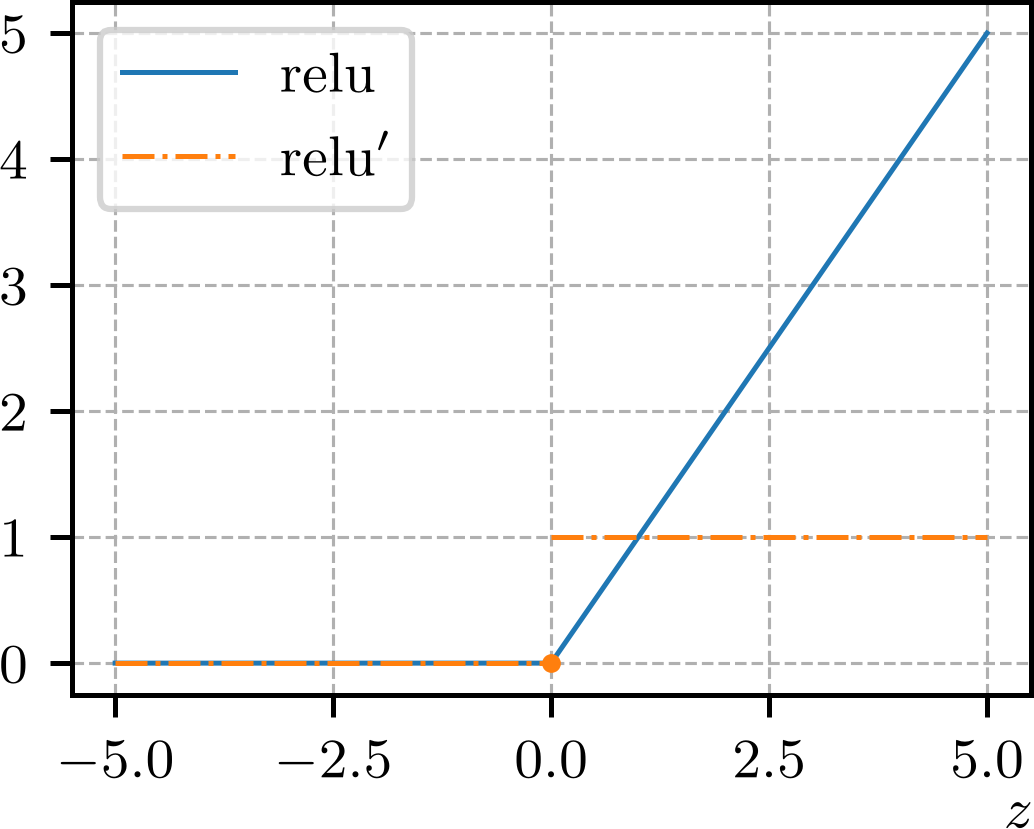
Algumas características da função ReLU são:
-
•
Função não limitada e monotonicamente não decrescente.
Embora a função ReLU seja não limitada, sua derivada é, o que na estabilidade numérica do treinamento de redes neurais.
-
•
Função positiva.
-
•
Função com derivadas mais altas nulas.
Embora a função ReLU seja diferenciável quase em todo o seu domínio, suas derivadas de ordens mais altas são nulas. Este é um problema para o treinamento de redes neurais em aplicações envolvendo equações diferenciais, em que termos envolvendo derivadas de ordens mais altas podem aparecer na função de perda. Neste caso, a função ReLU não é uma boa escolha como função de ativação.
-
•
Função não saturada.
Esta é uma das principais vantagens da função ReLU em relação às funções tangente hiperbólica e sigmoide. A função ReLU não satura para valores de entrada positivos, o que ajuda a evitar o problema do vanishing gradient durante o treinamento da rede.
-
•
Função nula para valores de entrada negativos.
Esta é uma das principais vantagens da função ReLU em aplicações com grandes redes neurais. A função ReLU é nula para valores de entrada negativos, o que ajuda na desativação de neurônios que não contribuem para a saída da rede, tornando o treinamento mais eficiente e menos sensível a ruídos nos dados de entrada.
-
•
Custo computacional baixo.
Em comparação com as funções tangente hiperbólica e sigmoide, a função ReLU tem um custo computacional baixo, o que é uma grande vantangem em aplicações que exigem grandes redes neurais.
2.4.4 Função Softplus
A função Softplus é uma função não linear, diferenciável e limitada inferiormente, com valores de saída no intervalo . A Figura 2.11 contém o gráfico da função Softplus e de sua derivada. Sua expressão analítica é dada por
| (2.69) |
e sua derivada é
| (2.70) |
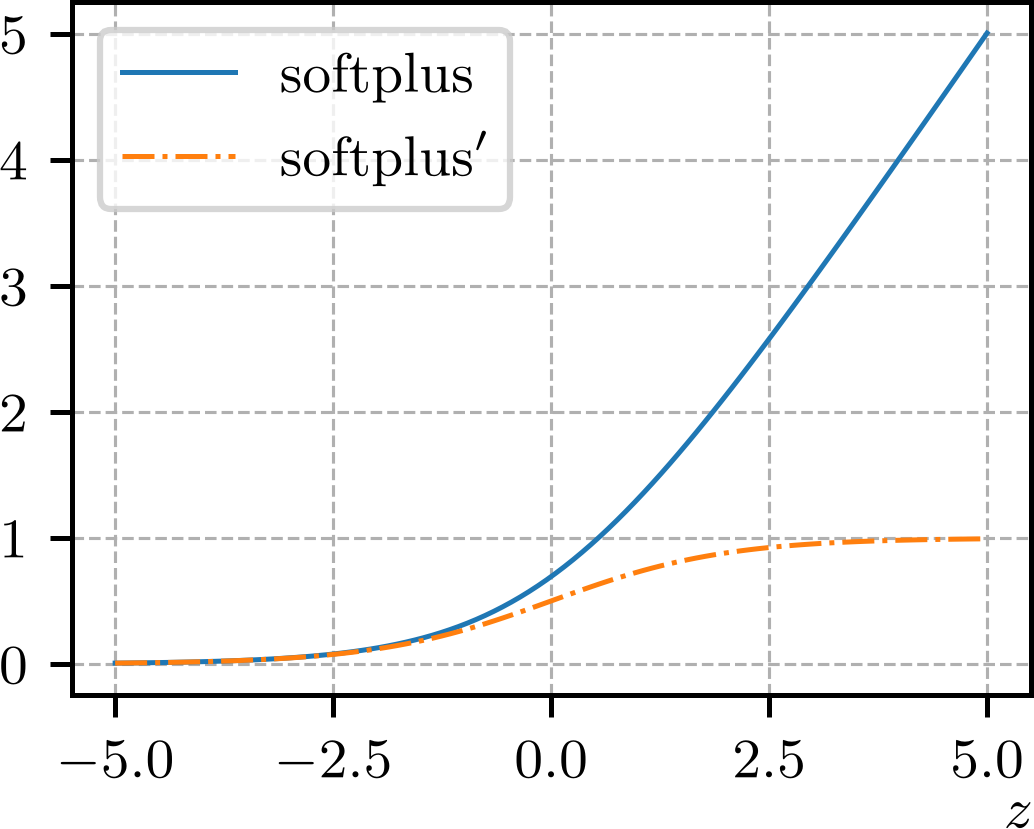
Algumas características da função Softplus são:
-
•
Função suave.
-
•
Função monotonicamente crescente.
-
•
Função não limitada com derivada limitada.
-
•
Função positiva.
-
•
Custo computacional alto.
2.4.5 Exercícios
E. 2.4.1.
Crie modelos de perceptrons (uma única unidade de processamento), utilizando as funções de ativação conforme indicado em cada item a seguir. Treine cada modelo para emular a operação lógica or e compare os resultados obtidos. Qual(is) a(s) melhor(es) função(ões) de ativação para este problema? Justifique sua resposta.
-
a)
Função tangente hiperbólica.
-
b)
Função sigmoide.
-
c)
Função ReLU.
-
d)
Função Softplus.
E. 2.4.2.
Crie modelo de MLPs com uma camada escondida com dois neurônios, utilizando as funções de ativação conforme indicado em cada item a seguir. Treine cada modelo para emular a operação lógica xor e compare os resultados obtidos. Qual(is) a(s) melhor(es) função(ões) de ativação para este problema? Justifique sua resposta.
-
a)
Camada escondida com função tangente hiperbólica e camada de saída com função identidade.
-
b)
Camada escondida e camada de saída com função sigmoide.
-
c)
Camada escondida com função tangente hiperbólica e camada de saída com função sigmoide.
-
d)
Camada escondida com função ReLU e camada de saída com função identidade.
-
e)
Camada escondida e camada de saída com função Softplus.
E. 2.4.3.
Considere MLPs com uma camada escondida com neurônios, utilizando as funções de ativação ReLU na camada escondida e função identidade na camada de saída. Treine cada modelo para emular a operação lógica and e verifique o efeito do número de neurônios na camada escondida. A partir de qual número de neurônios a rede passa a desativar neurônios na camada escondida? Justifique sua resposta.
E. 2.4.4.
Faça um estudo comparativo do tempo computacional de inferência das funções de ativação estudadas nesta seção. Quanto mais rápida é a função ReLU em relação às demais funções de ativação? Justifique sua resposta.
E. 2.4.5.
Crie uma MLP para emular as operações lógicas and, or e xor com uma única rede. Isto é, a rede deve ter três saídas, cada uma emulando uma das operações. Escolha as funções de ativação mais adequadas para cada camada da rede e treine seu modelo por retropropagação com o otimizador GDE.
Envie seu comentário
Aproveito para agradecer a todas/os que de forma assídua ou esporádica contribuem enviando correções, sugestões e críticas!

Este texto é disponibilizado nos termos da Licença Creative Commons Atribuição-CompartilhaIgual 4.0 Internacional. Ícones e elementos gráficos podem estar sujeitos a condições adicionais.