Política de uso de dados
Ao navegar por este site, você concorda com a política de uso de dados.Política de uso de dados
Ao navegar por este site, você concorda com a política de uso de dados.Introdução a PINNs
Ajude a manter o site livre, gratuito e sem propagandas. Colabore!
2.5 Aproximação de funções
Redes perceptron multicamadas (MLPs) são aproximadoras universais e vamos aplicá-las na aproximação de funções.
2.5.1 Teorema da aproximação universal
O teorema da aproximação universal pode ser visto como uma extensão do teorema de Weierstrass111111Karl Theodor Wilhelm Weierstrass, 1815 - 1897, matemático alemão. Fonte: Wikipédia: Karl Weierstrass. para redes neurais. Ele afirma que uma MLP com uma camada oculta e uma função de ativação não linear pode aproximar qualquer função contínua em um espaço compacto, com precisão arbitrária, desde que a rede tenha um número suficiente de neurônios na camada oculta.
Teorema 2.5.1.(Aproximação universal)
Seja uma função contínua monotonicamente crescente e limitada. Sejam e uma dada função contínua de em . Então, para todo , existe um e um conjunto de constantes reais , e , , tais que a função
| (2.71) |
é uma aproximação de em no sentido de que
| (2.72) |
Demonstração.
O Teorema 2.5.1 é diretamente aplicável a uma rede MLP com uma camada escondida, tangente hiperbólica como função de ativação e uma camada de saída com função de ativação identidade. Ele garante que, para qualquer função contínua em um espaço compacto, existe uma MLP com essa arquitetura que pode aproximar com precisão arbitrária, desde que a camada escondida tenha um número suficiente de neurônios. A extensão do teorema para a aproximação de funções multivariadas é direta.
Redes MLP com função de ativação ReLU não se encaixam no Teorema 2.5.1. Entretanto, resultados teóricos sobre a aproximação de funções com tais redes também estão disponíveis. Consulte, por exemplo, [9].
O Teorema 2.5.1 é um resultado teórico importante, pois estabelece a capacidade de aproximação das MLPs. No entanto, ele não fornece uma maneira prática de determinar o número de neurônios necessários na camada escondida para alcançar uma determinada precisão, nem garante que o processo de treinamento da rede encontrará os pesos e biases adequados para realizar a aproximação desejada. Ainda, o teorema não estabelece que redes com apenas uma camada escondida sejam as melhores para a aproximação de funções, e sim que elas são suficientes. Na prática, redes com múltiplas camadas escondidas (redes profundas) podem ser mais eficientes para aproximar funções complexas.
2.5.2 Aproximação de função de uma variável
Vamos criar uma MLP para aproximar a função
| (2.73) |
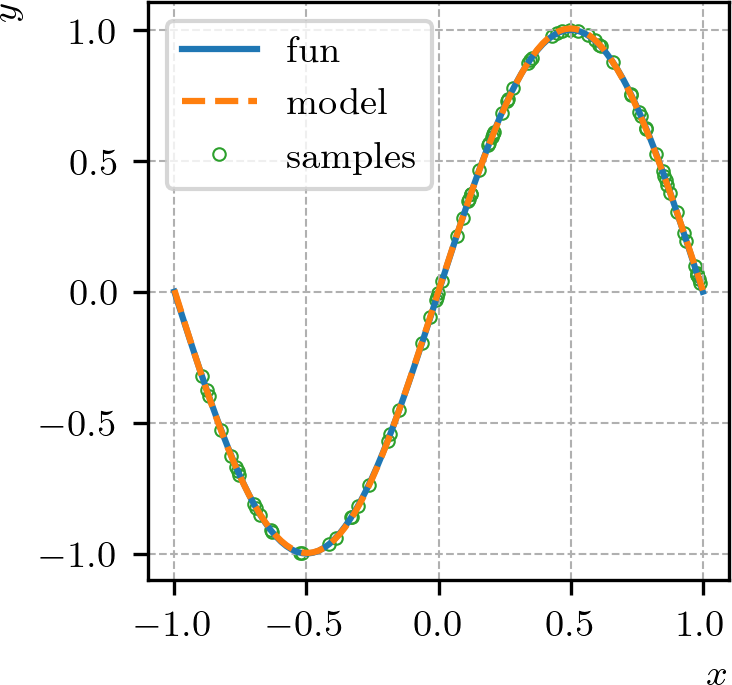
para . A Figura 2.12 contém o gráfico da função e da aproximação obtida com a MLP. A linha contínua representa a função, a linha tracejada representa a MLP e os pontos representam as amostras de treinamento na última época do treinamento. O resultado foi obtido com o Código 11 que discutiremos com mais detalhes na sequência.
No início do Código 11 verificamos se há uma GPU disponível para o treinamento da rede. Caso haja, o treinamento é feito na GPU, caso contrário, ele é feito na CPU. A GPU é um dispositivo de processamento paralelo que pode acelerar significativamente o treinamento de redes neurais, especialmente para redes grandes e conjuntos de dados extensos (mesmo que este não seja o caso aqui).
Usamos uma arquitetura de rede (uma entrada, uma camada escondida com 25 neurônios e uma saída). A função de ativação da camada escondida é a tangente hiperbólica e a função de ativação da camada de saída é a função identidade. A cada época, pontos randômicos são gerados no intervalo e usados como amostras de treinamento. A função de perda é o erro médio quadrático
| (2.74) |
dos valores estimados e dos valores esperados . O treinamento é interrompido quando a função de perda de validação atinge uma tolerância de por 10 épocas consecutivas (persistência).
O otimizador escolhido é uma variante do método GDE com momentum para o treinamento da rede. Nesta variante, a direção de atualização dos parâmetros da rede é uma combinação linear da direção de atualização da época anterior e do gradiente atual. Esta abordagem tem um grande potencial de acelerar a convergência do treinamento, principalmente quando o GDE com momentum é aplicado em conjunto com uma boa inicialização dos parâmetros da rede [32]. O algoritmo do GDE com momentum utilizado no código é dado por121212O algoritmo do GDE com momentum apresentado aqui é a variante implementada na biblioteca PyTorch.
| (2.75) | |||
| (2.76) |
onde é o vetor de atualização dos parâmetros da rede na época , é o parâmetro de momentum. Na primeira época, aplica-se o método GDE sem momentum. No código, usamos e .
Escolha da arquitetura
A arquitetura (número de camadas escondidas e números de neurônios por camada) de uma rede tem impacto direto na sua capacidade de aprendizagem. Redes pequenas (pouco profundas e com poucos neurônios) têm um custo computacional de inferência pequeno, mas pouca capacidade de armazenar e representar funções complicadas. Quanto mais complicada for a função a ser aproximada, maior precisa ser a rede neural. Por outro lado, uma rede muito grande têm um custo de inferência alto e, devido ao seu grande número de parâmetros, o treinamento envolve um problema de otimização muito mais complicado. Redes desnecessariamente grandes devem ser evitadas.
Um técnica básica de escolha da arquitetura é a busca em grade. Nela, constrói-se uma tabela em que as linhas correspondem ao número de camadas escondidas e as colunas são o número de neurônios de cada camada. As entradas da tabela são uma ou mais quantidades de interesse que venham a indicar a eficiência do treinamento de cada rede.
Por exemplo, vamos aplicar a busca em grade para escolher uma arquitetura adequada de uma MLP para o problema de aproximação que estudamos aqui nesta Subseção 2.5.2. Na Tabela 2.5 temos o resultado da busca em grade para o número de camadas escondidas e o número de neurônios por camada . Cada entrada da tabela contém o número de épocas necessárias para atingir o critério de parada e o tempo computacional de treinamento. Cada teste foi repetido 10 vezes e a média dos resultados é apresentada na tabela. As entradas destacadas em negrito indicam as arquiteturas que obtiveram os melhor desempenho. O tempo computacional (walltime) foi obtido rodando o código em GPU num computador Linux (versão do kernel 7.0.0-38-generic) com processador Intel Core Ultra 7 155H 16, GPU NVIDIA GeForce RTX 5060 Laptop e 32 GB (DDR5) de memória RAM.
Com base nos resultados da Tabela 2.5 e se o critério de escolha for a menor rede, a arquitetura seria a melhor escolha. Os resultados também indicam que mais estudos poderiam ser feitos para arquiteturas de a um pouco mais de neurônios por camada escondida. O número de testes por arquitetura também poderia ser aumentado para uma melhor estatística dos resultados. Verifique!
2.5.3 Aproximação de uma função de duas variáveis
Vamos criar uma MLP para aproximar a função
| (2.77) |
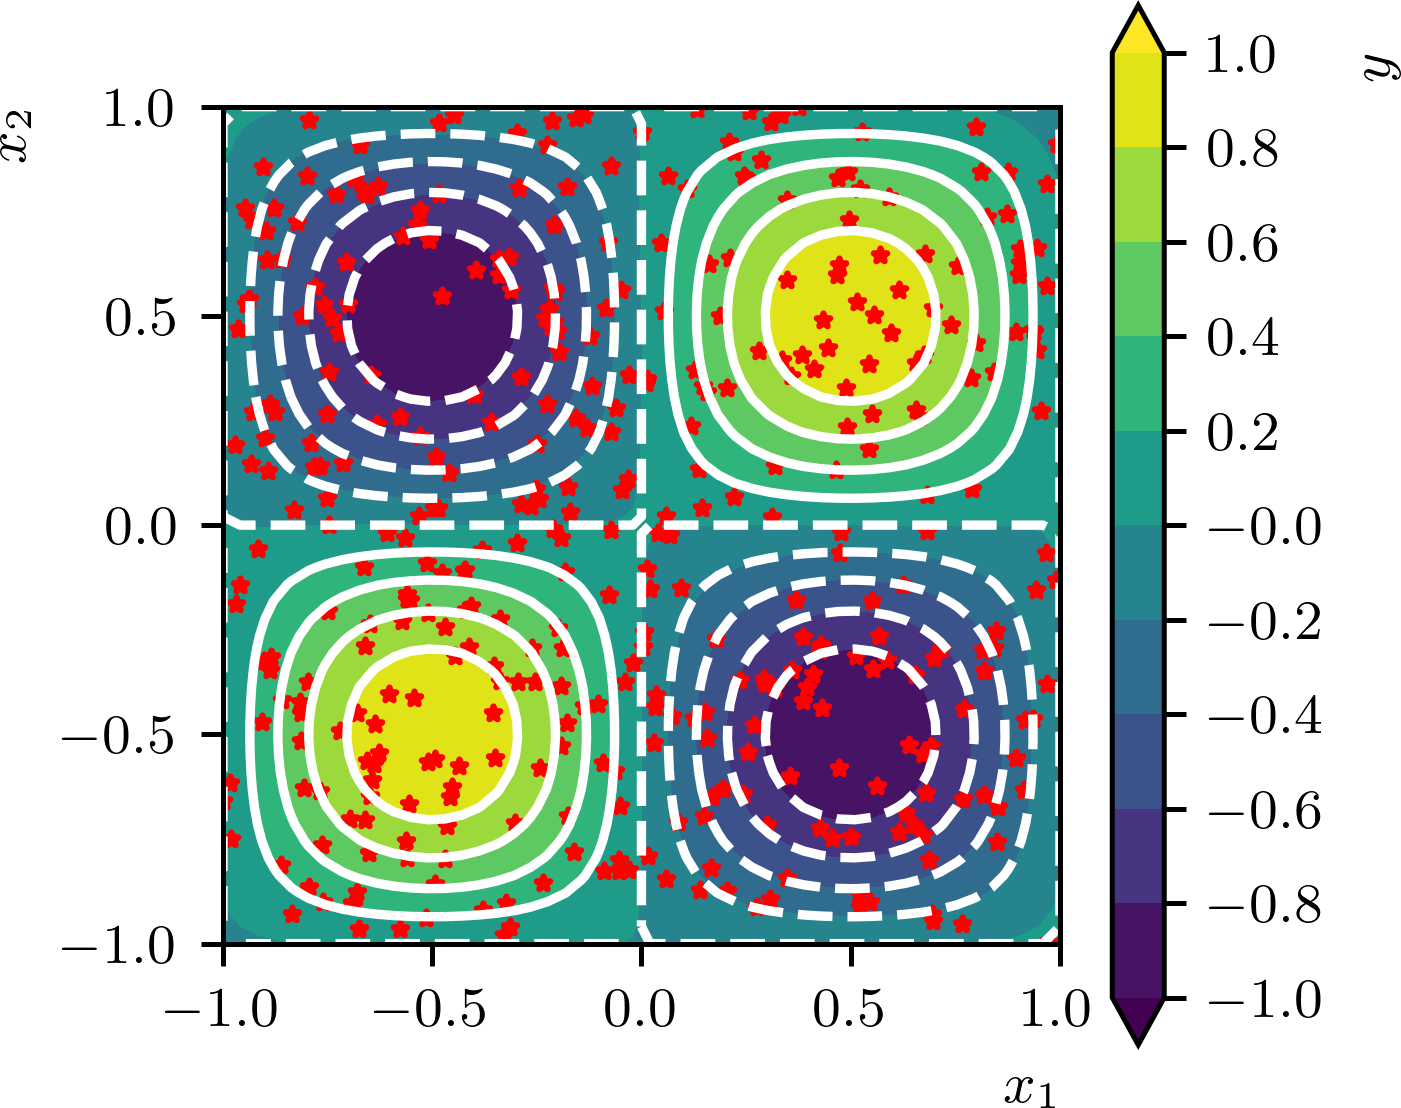
para . A Figura 2.13 contém o gráfico da função e de uma aproximação obtida com uma MLP. As linhas representam as isolinhas da função estimada pela MLP, o mapa de cores representa a saída da MLP e as estrelas representam os pontos de treinamento na última época do treinamento. O resultado foi obtido com o Código 12 que discutiremos com mais detalhes na sequência.
No Código 12, treinamos uma MLP com arquitetura (duas entradas, duas camadas escondidas com 30 neurônios cada e uma saída). A função de ativação das camadas escondidas é a tangente hiperbólica e a função de ativação da camada de saída é a função identidade. A cada época, pontos randômicos são gerados no domínio e usados como amostras de treinamento. A função de perda é o erro médio quadrático
| (2.78) |
dos valores estimados e dos valores esperados . O treinamento é interrompido quando a função de perda em pontos de validação atinge uma tolerância de .
Para este problema, o otimizador escolhido foi o método Adam (do inglês, Adaptive Moment Estimation, [19]). Assim como o GDE, ele é um método de otimização baseado no gradiente. Ele calcula taxas de aprendizado adaptativas para cada parâmetro da rede, com base nas estimativas de primeira e segunda ordem dos momentos dos gradientes. Os detalhes de implementação deste método fogem aos objetivos aqui. Para mais detalhes, consulte [19]131313Para detalhes da implementação do método Adam na biblioteca PyTorch, consulte: https://docs.pytorch.org/docs/2.14/generated/torch.optim.Adam.htm..
2.5.4 Exercícios
E. 2.5.1.
Crie uma MLP para aproximar a função gaussiana para .
E. 2.5.2.
Crie uma MLP para aproximar a função para .
E. 2.5.3.
Crie uma MLP para aproximar a função para .
E. 2.5.4.
Crie uma MLP para aproximar a função gaussiana para .
E. 2.5.5.
Crie uma MLP para aproximar a função para .
Envie seu comentário
Aproveito para agradecer a todas/os que de forma assídua ou esporádica contribuem enviando correções, sugestões e críticas!

Este texto é disponibilizado nos termos da Licença Creative Commons Atribuição-CompartilhaIgual 4.0 Internacional. Ícones e elementos gráficos podem estar sujeitos a condições adicionais.