Política de uso de dados
Ao navegar por este site, você concorda com a política de uso de dados.Política de uso de dados
Ao navegar por este site, você concorda com a política de uso de dados.Introdução a PINNs
Ajude a manter o site livre, gratuito e sem propagandas. Colabore!
2.6 Diferenciação automática
Diferenciação automática é um conjunto de técnicas para a computação de derivadas numéricas em um programa de computador. Explora-se o fato de que um programa computacional executa uma sequência de operações aritméticas e funções elementares, podendo-se computar a derivada por aplicações da regra da cadeia.
PyTorch computa o gradiente (derivada) de uma função a partir de seu grafo computacional. Os gradientes são computados por retropropagação. Por exemplo, para a computação do gradiente
| (2.79) |
primeiramente, propaga-se a entrada pela função computacional , obtendo-se . Então, o gradiente é computado por retropropagação.
Exemplo 2.6.1.
Seja e vamos computar
| (2.80) |
por diferenciação automática.
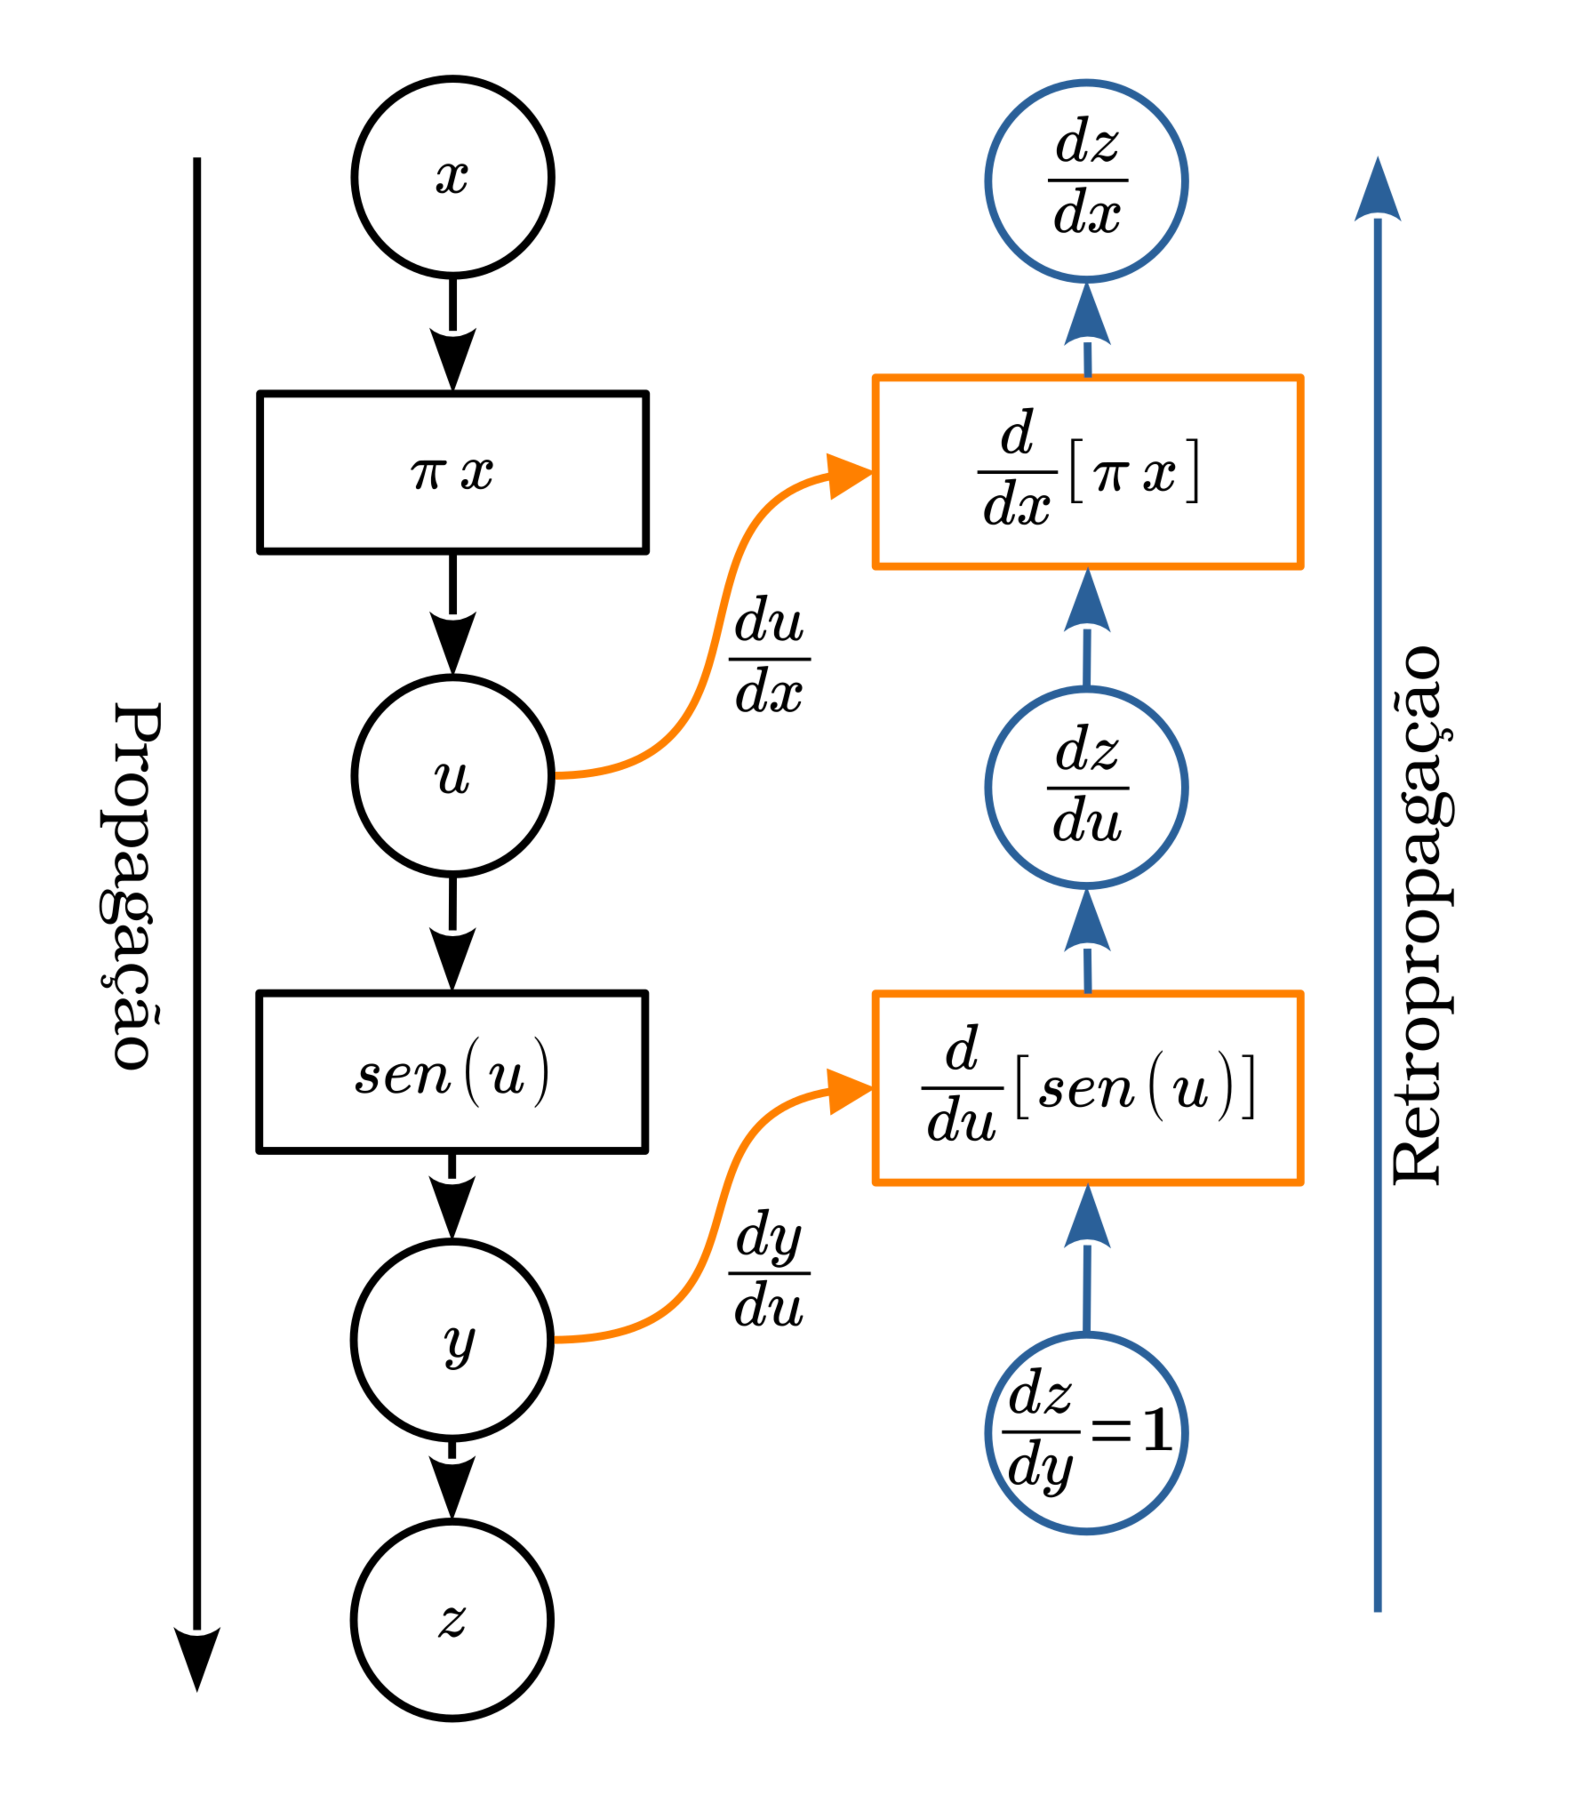
A Figura 2.14 mostra o grafo computacional da função . A entrada é propagada formando o grafo de propagação. Ao grafo de propagação, folhas são adicionadas contendo as derivadas de cada operação. Para a computação do gradiente, adicionamos uma variável fictícia e, então, o gradiente é computado por retropropagação. A retropropagação é feita da seguinte forma
| (2.81) | |||
| (2.82) | |||
| (2.83) | |||
| (2.84) |
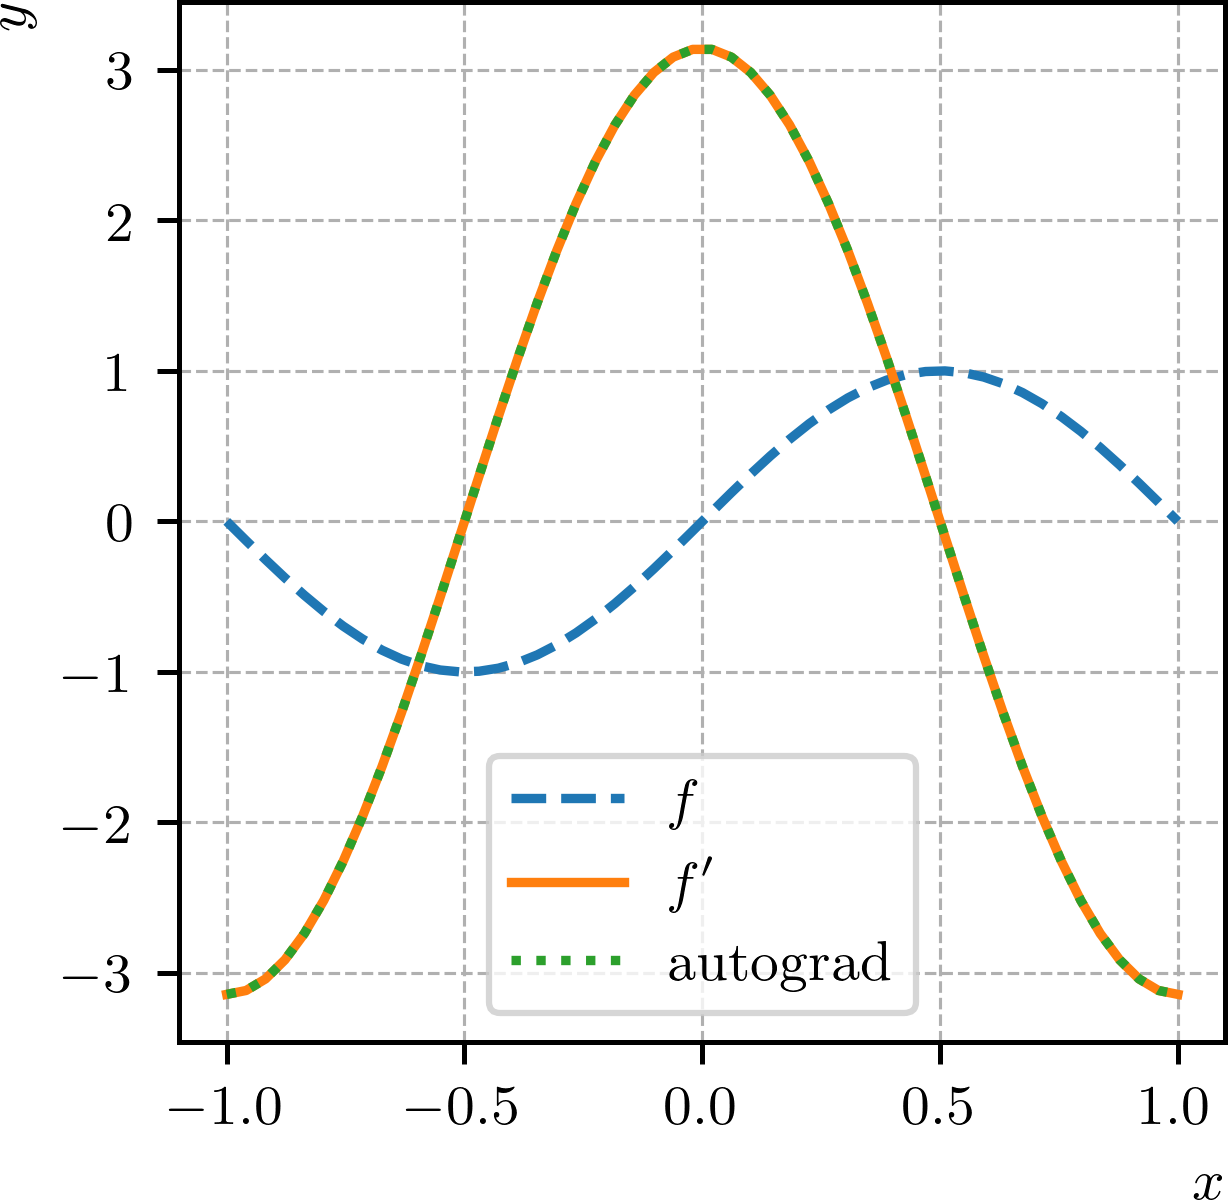
O Código 13 contém uma implementação PyTorch da diferenciação automática da função para . Observe que para a computação do gradiente, a entrada deve ser marcada com o atributo requires_grad=True. O comando y.backward() computa o gradiente de em relação a . O argumento gradient=ones_like(y) é usado para especificar o vetor de gradientes iniciais para a retropropagação. Este é o neste exemplo aqui. O gradiente é armazenado no atributo x.grad. Ainda, a Figura 2.15 mostra a comparação entre as diferenciações analítica () e automática (autograd). Observemos que os resultados são idênticos, com diferenças da ordem de , que é a precisão numérica do PyTorch141414Por padrão, o PyTorch usa pontos flutuantes de -bits, com precisão aproximada de ..
O grafo computacional da retropropagação pode ser recuperado no PyTorch com o seguinte código (Código 14).
Observemos que a computação do gradiente de primeira ordem também acaba por construir um novo grafo. Este, por sua vez, pode ser usado para a computação da diferenciação automática de segunda ordem, i.e. para a derivação de segunda ordem.
Exemplo 2.6.2.
Vamos computar a segunda derivada da função por diferenciação automática. O primeiro passo é propagar a entrada pela função , obtendo-se . Em seguida, computamos o gradiente de primeira ordem por retropropagação. O gradiente de segunda ordem é computado propagando-se o gradiente de primeira ordem pelo grafo computacional da retropropagação, obtendo-se .
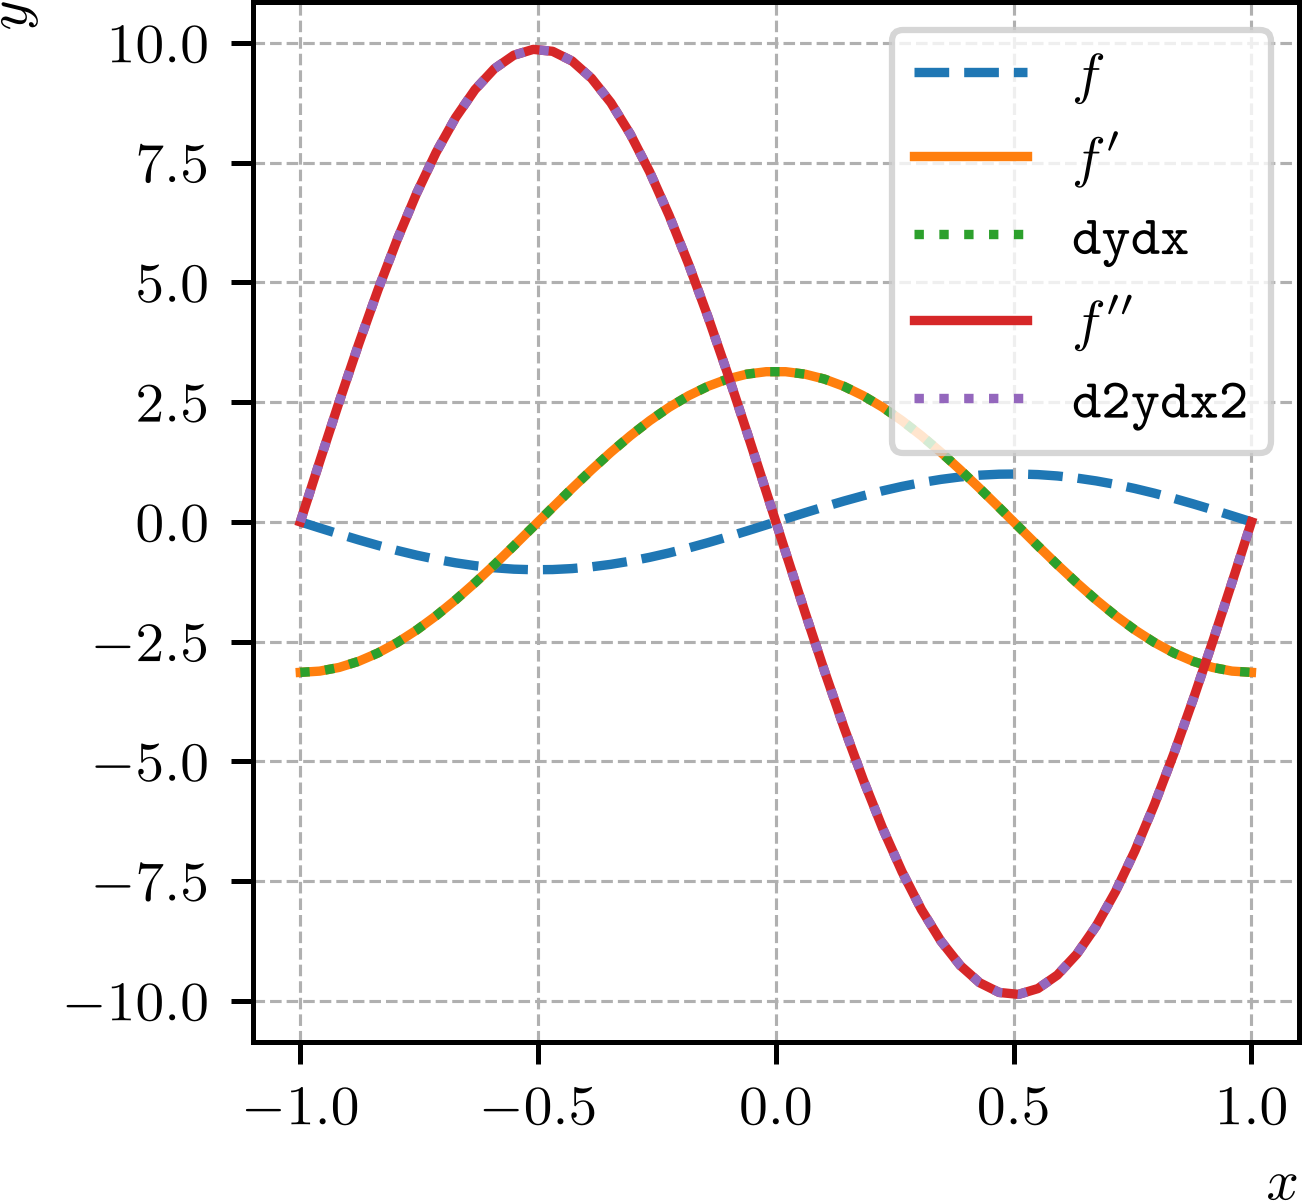
O Código 15 contém uma implementação PyTorch da diferenciação automática de segunda ordem dessa função para . A Figura 2.16 mostra a comparação entre as diferenciações analítica (, ) e automática (dydx, d2ydx2). Observemos que os resultados são idênticos, com diferenças na ordem da precisão computacional do PyTorch, que é da ordem de . Verifique!
2.6.1 Autograd MLP
Os conceitos de diferenciação automática (autograd) são diretamente estendidos para redes do tipo Perceptron Multicamadas (MLP, do inglês, Multilayer Perceptron). Uma MLP é uma composição de funções definidas por parâmetros (pesos e biases). Como estudamos na Subseção 2.2, seu treinamento também pode ser feito por retropropagação em duas etapas:
-
1.
Propagação (forward): os dados de entrada são propagados para todas as funções da rede, produzindo a saída estimada.
-
2.
Retropropagação (backward): a computação do gradiente do erro151515Medida da diferença entre o valor estimado e o valor esperado. em relação aos parâmetros da rede é realizada coletando as derivadas (gradientes) das funções da rede. Pela regra da cadeia, essa coleta é feita a partir da camada de saída em direção à camada de entrada da rede.
No seguinte exemplo, exploramos o fato de MLPs serem aproximadoras universais e avaliamos as aproximações das derivadas de primeira e segunda ordem de uma MLP na aproximação de uma função.
Exemplo 2.6.3.
Na Subseção 2.5.2, criamos uma MLP para aproximar a função para . Aqui, vamos computar as derivadas de primeira e segunda ordem da MLP por diferenciação automática e comparar com as derivadas analíticas da função , que são
| (2.85) | |||
| (2.86) |
Antes de computarmos os gradientes da MLP, voltemos ao Código 11 para adicionarmos uma linha de código ao final do treinamento da MLP, que armazena o modelo treinado em um arquivo. A linha de código é
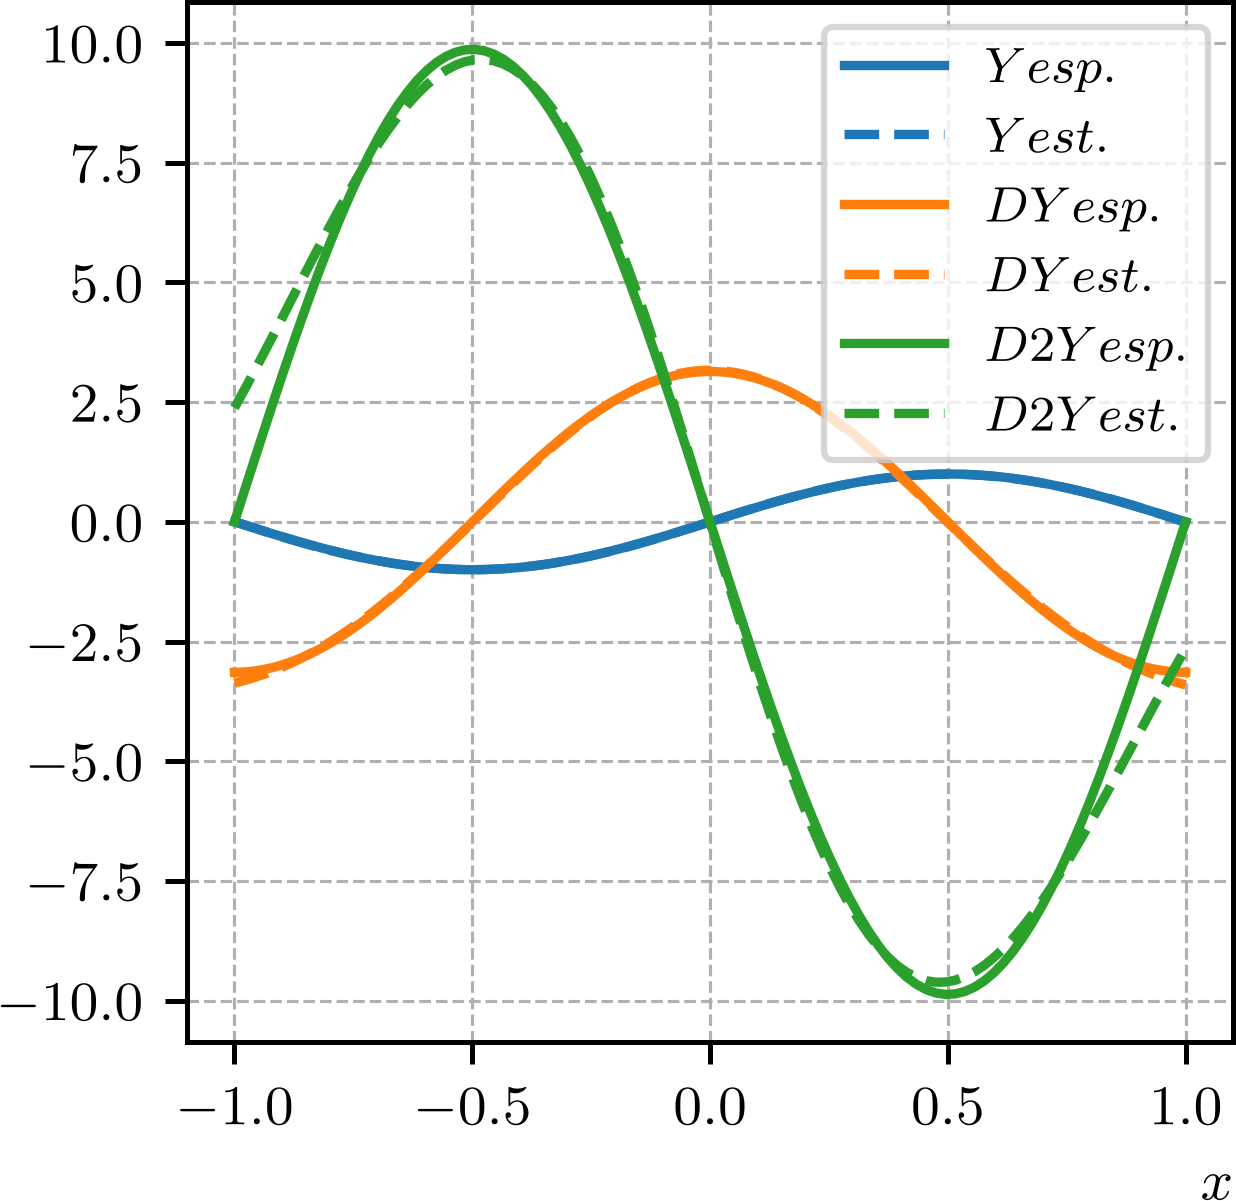
Armazenado o modelo treinado, podemos carregá-lo em outro código para computarmos os gradientes de primeira e segunda ordem da MLP. O Código 16 contém uma implementação PyTorch da diferenciação automática da MLP para alguns valores de . A Figura 2.17 mostra a comparação entre os gradientes analíticos e automáticos de primeira e segunda ordem da MLP. Observemos que as aproximações das derivadas são boas, mas dependem da qualidade da aproximação da função pela MLP e as diferenças aumentam com a ordem da derivada. Verifique!
2.6.2 Exercícios
E. 2.6.1.
Por diferenciação automática, compute o gradiente (a derivada) das seguintes funções:
-
a)
para valores .
-
b)
para valores .
-
c)
para valores .
-
d)
para valores .
Em cada caso, monte os grafos computacionais da propagação e da retropropagação na computação dos gradientes. Compare os valores computados com os valores esperados.
E. 2.6.2.
Para cada função no E.2.6.1, crie uma MLP para aproximar a função e, por diferenciação automática, compute as derivadas de primeira e segunda ordem. Compare os valores computados com os valores esperados.
E. 2.6.3.
Por diferenciação automática, compute os gradientes das seguintes funções:
-
a)
para valores .
-
b)
para valores .
Em cada caso, monte os grafos computacionais da propagação e da retropropagação na computação dos gradientes. Compare os valores computados com os valores esperados.
E. 2.6.4.
Para cada função no E.2.6.3, crie uma MLP para aproximar a função e compute as derivadas , , , e pela MLP. Compare os valores computados com os valores esperados.
E. 2.6.5.
Para cada função no E.2.6.3, crie uma MLP para aproximar a função e compute o laplacino pela MLP. Compare os valores computados com os valores esperados.
Envie seu comentário
Aproveito para agradecer a todas/os que de forma assídua ou esporádica contribuem enviando correções, sugestões e críticas!

Este texto é disponibilizado nos termos da Licença Creative Commons Atribuição-CompartilhaIgual 4.0 Internacional. Ícones e elementos gráficos podem estar sujeitos a condições adicionais.