Política de uso de dados
Ao navegar por este site, você concorda com a política de uso de dados.Política de uso de dados
Ao navegar por este site, você concorda com a política de uso de dados.Matemática numérica I
Ajude a manter o site livre, gratuito e sem propagandas. Colabore!
3.4 Método do gradiente
Começamos observando que se é uma matriz positiva definida111111 é simétrica e para todo ., temos que é solução de
| (3.293) |
se, e somente se, é solução do seguinte problema de minimização
| (3.294) |
De fato, sejam a solução de (3.293) e a solução de (3.294), então
| (3.295) | |||
| (3.296) | |||
| (3.297) |
O segundo termo é independente de e, como é positiva definida, temos
| (3.298) |
Logo, o mínimo de ocorre quando , i.e. .
A iteração do Método do Gradiente tem a forma
| (3.299) | |||
| (3.300) |
para , onde é o tamanho do passo e é o vetor direção de busca.
Para escolhermos a direção , tomamos a fórmula de Taylor de em torno da aproximação
| (3.301) |
onde denota o gradiente de , i.e.
| (3.302) | ||||
| (3.303) |
De , segue que se
| (3.304) |
então , para suficientemente pequeno. Em particular, podemos escolher
| (3.305) |
se .
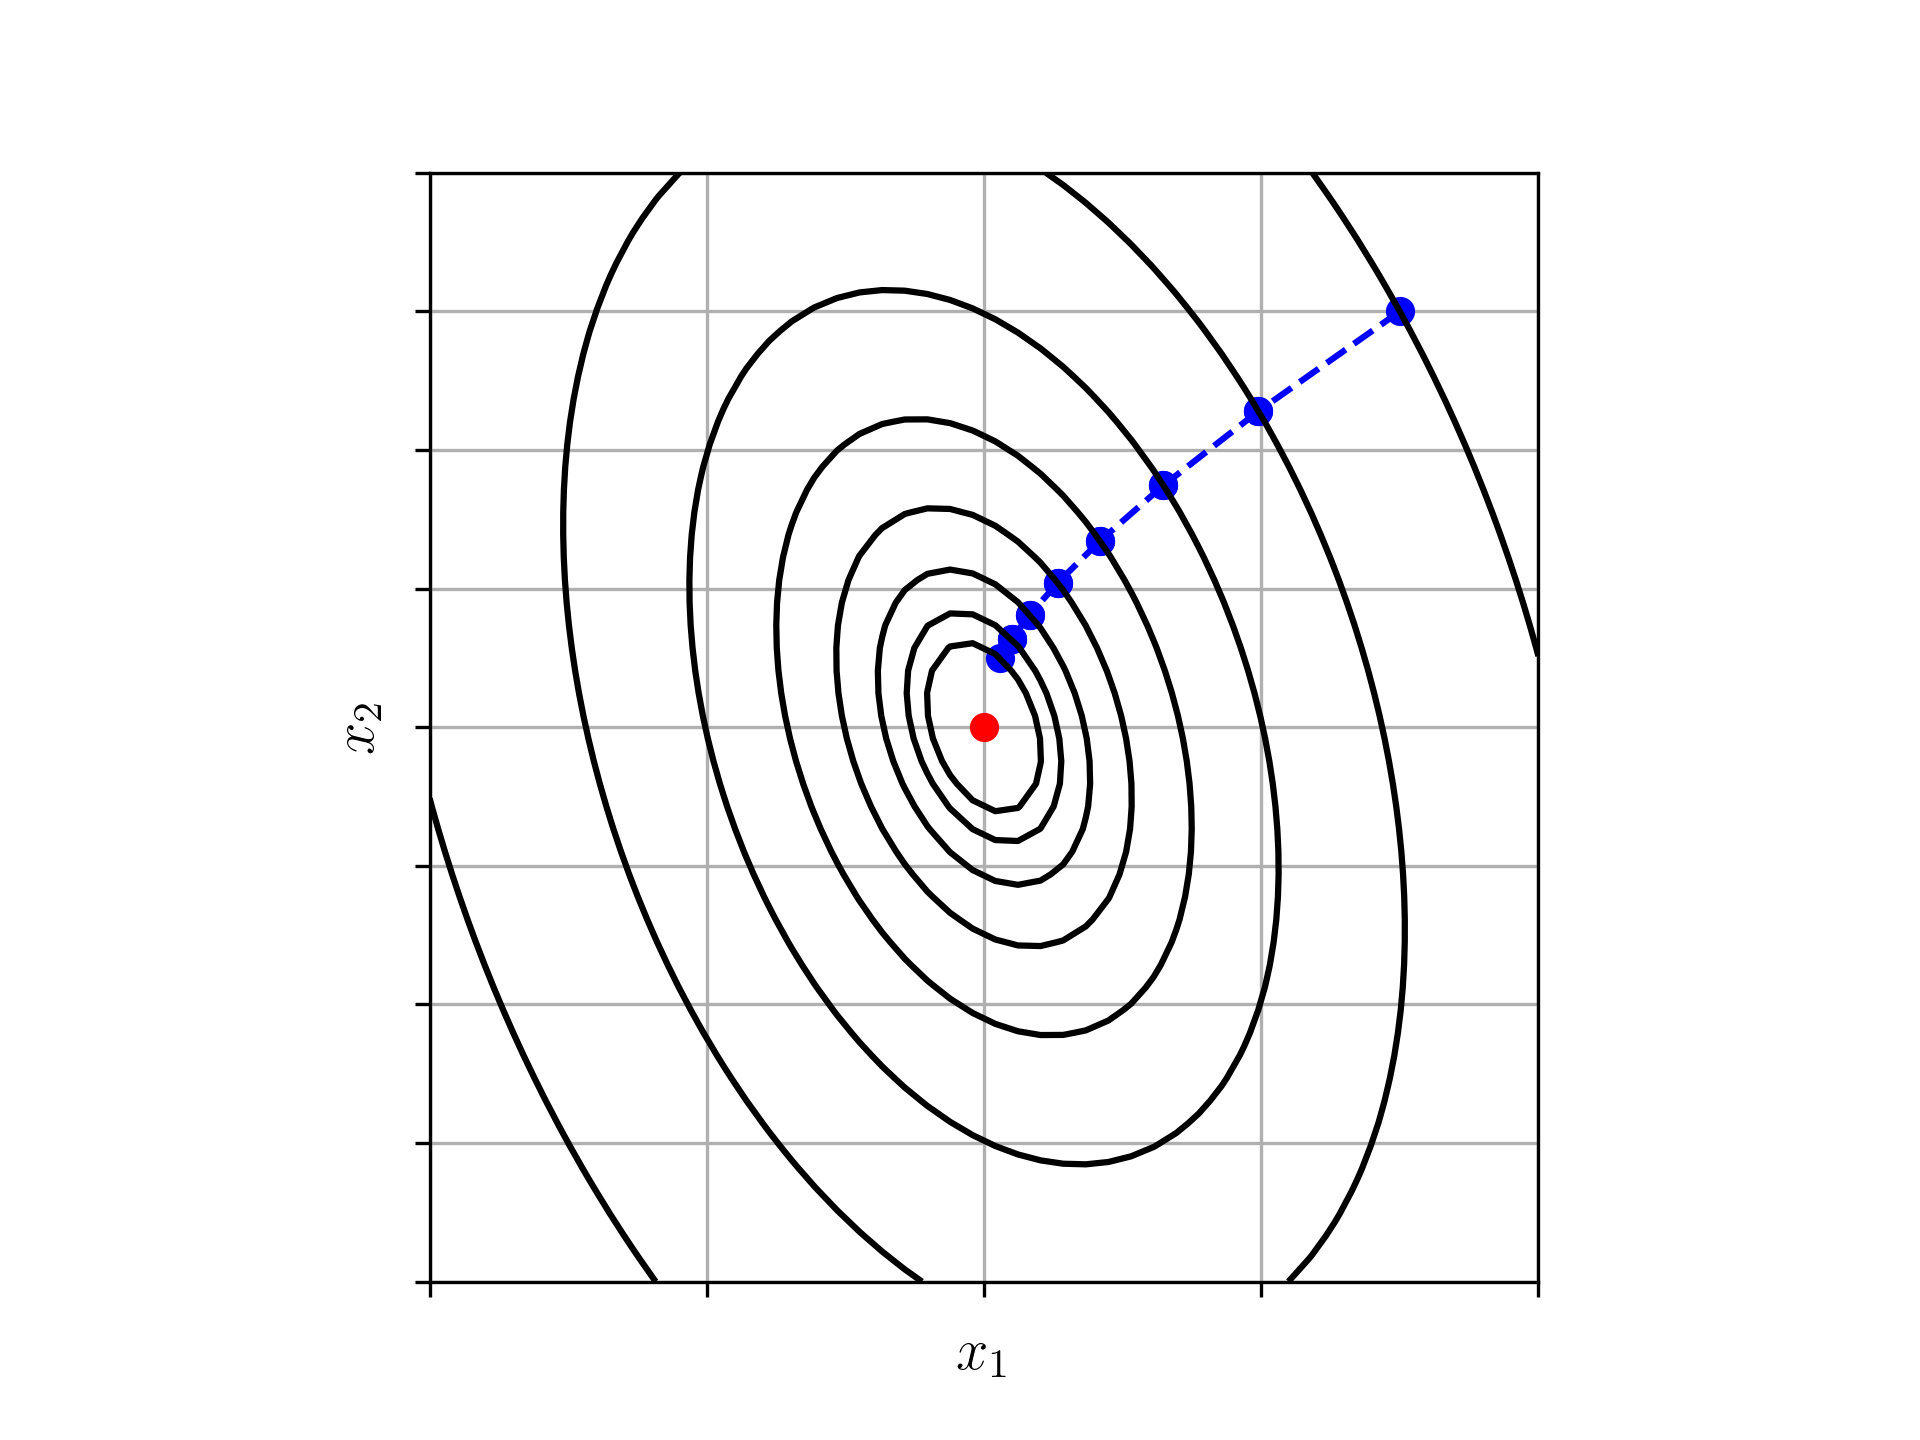
Do exposto acima, temos a iteração do Método do Gradiente
| (3.306) | |||
| (3.307) |
com , onde é o resíduo
| (3.308) |
Exemplo 3.4.1.
Consideramos o sistema com
| (3.309) | |||
| (3.310) |
Na Tabela 3.3 temos os resultados do emprego do método do gradiente com e com passo constante .
| k | ||
|---|---|---|
| 0 | ||
| 1 | ||
| 2 | ||
| 3 | ||
| 4 | ||
| 5 | ||
| 6 | ||
| 7 | ||
| 8 | ||
| 9 | ||
| 10 |
3.4.1 Escolha do passo
Para a escolha do passo, podemos usar o Método da Pesquisa Linear. A ideia é escolher o passo tal que
| (3.311) |
Observando que é função apenas de , temos que seu mínimo ocorre em seu ponto crítico, i.e.
| (3.312) | |||
| (3.313) | |||
| (3.314) | |||
| (3.315) | |||
| (3.316) |
donde
| (3.317) |
Exemplo 3.4.2.
Consideramos o sistema com
| (3.318) | |||
| (3.319) |
Na Tabela 3.4 temos os resultados do emprego do método do gradiente com e com passo escolhido conforme (3.317).
| k | |||
|---|---|---|---|
3.4.2 Exercícios
E. 3.4.1.
Considere o sistema linear com
| (3.320) | |||
| (3.321) |
Por tentativa e erro, encontre um valor para tal que o Método do Gradiente converge para solução do sistema em menos de iterações. Use
| (3.322) |
como aproximação inicial e assuma o critério de parada
| (3.323) |
onde é o resíduo do sistema e .
,
E. 3.4.2.
Considere o sistema linear com
| (3.324) | |||
| (3.325) |
Por tentativa e erro, encontre um valor para tal que o Método do Gradiente converge para solução do sistema em menos de iterações. Use
| (3.326) |
como aproximação inicial e assuma o critério de parada
| (3.327) |
onde é o resíduo do sistema e .
,
E. 3.4.3.
Considere o sistema linear dado no E.3.4.1. Utilizando a mesma aproximação inicial e tolerância, aplique o Método do Gradiente com Pesquisa Linear. Quantas iterações são necessárias até a convergência e qual o valor médio de utilizado durante as iterações?
,
E. 3.4.4.
Considere o sistema linear dado no E.3.4.2. Utilizando a mesma aproximação inicial e tolerância, aplique o Método do Gradiente com Pesquisa Linear. Quantas iterações são necessárias até a convergência e qual o valor médio de utilizado durante as iterações?
,
E. 3.4.5.
Considere o problema de Laplace
| (3.328) | ||||
| (3.329) |
A discretização pelo Método das Diferenças Finitas em uma malha uniforme , , , leva ao seguinte sistema linear
| (3.330) | |||
| (3.331) | |||
| (3.332) |
onde . Com , aplique o Método do Gradiente com Pesquisa Linear para computar a solução deste sistema quando . Quantas iterações são necessárias para obter-se a convergência do método com critério de convergência
| (3.333) |
onde, é o resíduo e .
Análise numérica
E. 3.4.6.
Envie seu comentário
Aproveito para agradecer a todas/os que de forma assídua ou esporádica contribuem enviando correções, sugestões e críticas!

Este texto é disponibilizado nos termos da Licença Creative Commons Atribuição-CompartilhaIgual 4.0 Internacional. Ícones e elementos gráficos podem estar sujeitos a condições adicionais.